인덱스를 걸었는데도 속도가 생각보다 많이 줄지 않았다.
- 개발
- 2026. 10. 16. 01:35
인덱스를 걸면 속도가 빨라진다고 얘기한다. 실제로 2s가량의 1.1ms까지 감소가 된것을 확인했다. 하지만 이상하게도 하나의 쿼리는 속도가 생각보다 많이 줄지 않았다. 정확히 말하면 줄긴했지만 그렇다고 해서 유의미하게 준것은 아니었다. 왜 이런 현상이 발생했을까?
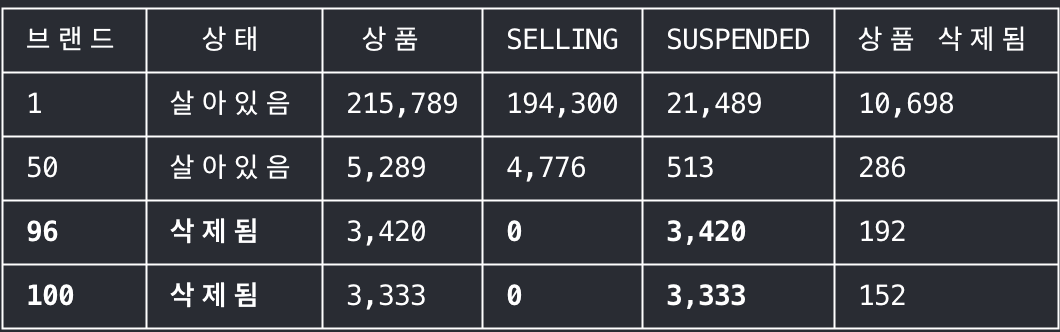
해당 쿼리는 다음과 같다.
SELECT p.id FROM product p LEFT JOIN product_like l
ON l.product_id=p.id WHERE p.deleted_at IS NULL
AND p.status='SELLING'
GROUP BY p.id
ORDER BY COUNT(l.id) DESC,
p.id DESC
LIMIT 20
어째서 이 쿼리는 인덱스를 타지 않았을까?
해당 쿼리의 인덱스를 걸기전 실행 계획을 확인해보자.
-> Limit: 20 row(s)  (actual time=3717..3717 rows=20 loops=1)
    -> Sort: `count(l.id)` DESC, p.id DESC, limit input to 20 row(s) per chunk  (actual time=3717..3717 rows=20 loops=1)
        -> Table scan on <temporary>  (actual time=3571..3667 rows=820942 loops=1)
            -> Aggregate using temporary table  (actual time=3571..3571 rows=820941 loops=1)
                -> Left hash join (l.product_id = p.id)  (cost=9.54e+9 rows=95.4e+9) (actual time=564..1270 rows=2.05e+6 loops=1)
                    -> Filter: ((p.`status` = 'SELLING') and (p.deleted_at is null))  (cost=100197 rows=48238) (actual time=0.151..310 rows=820942 loops=1)
                        -> Table scan on p  (cost=100197 rows=964759) (actual time=0.144..225 rows=1e+6 loops=1)
                    -> Hash
-> Table scan on l (cost=4.8 rows=1.98e+6) (actual time=0.794..393 rows=1.99e+6 loops=1)-> Filter: ((p.`status` = 'SELLING') and (p.deleted_at is null)) (cost=100197 rows=48238) (actual time=0.151..310 rows=820942 loops=1)
-> Table scan on p (cost=100197 rows=964759) (actual time=0.144..225 rows=1e+6 loops=1)Filter
그다음 Filter 단계에서는 status와 deleted_at으로 행을 거른다. SQL의 WHERE 절 조건이 여기서 처리된다. Filter의 비용이 100,197로 스캔과 같은 이유는 cost가 하위 단계 비용을 포함한 값이기 때문이다. 옵티마이저는 이 필터를 통과하는 행을 약 48,238개로 예측했다.
실제로는 820,942행이 통과했다. 예측보다 약 17배 많고, 전체 100만 행 중 82%에 해당한다. Filter의 actual time 310ms는 하위 단계인 스캔 225ms를 포함한 값이다. 따라서 이 구간 전체에 걸린 시간은 310ms이고, 그중 필터링만 따로 보면 약 85ms다.
status와 deleted_at은 인덱스 후보로 올려 둔다. 다만 82%가 통과하는 조건이라 걸러내는 비율이 낮다. 인덱스로 찾아간 뒤 테이블을 다시 읽는 것보다 풀 스캔이 더 쌀 수 있으므로, 실제로 효과가 있는지는 인덱스를 건 뒤 다시 측정해서 확인해야 한다.
-> Hash
-> Table scan on l (cost=4.8 rows=1.98e+6) (actual time=0.794..393 rows=1.99e+6 loops=1)이 구간의 예측 비용은 4.8로, 앞선 Filter 구간보다 훨씬 낮게 표시됐다. 하지만 비용이 낮다고 해서 가벼운 연산이라고 볼 수는 없다. 예상 행 수(1.98e+6)와 실제 행 수(1.99e+6) 모두 약 199만 행으로, Filter를 통과한 82만 행보다 훨씬 많다.
l 테이블 전체를 풀 스캔해 읽어 들이는 데 393ms가 걸렸다. 예측 비용은 낮게 표시됐지만, 실제로는 약 199만 행을 전부 읽어 해시 테이블을 만들었으므로 이 구간도 쿼리 전체에 적지 않은 부담을 준다.
Left hash join
이 구간에서 옵티마이저의 예측은 현실과 크게 동떨어져 있다. 예측 비용은 9.54e+9(약 95억), 예상 행 수는 95.4e+9(약 954억)다. 실제로는 205만 행이었다. 954억은 앞 단계 Filter의 예상 행 수(48,238)와 l 테이블의 예상 행 수(약 198만)를 곱한 값과 거의 같다. l.product_id에 인덱스나 통계가 없어 조인 조건이 행을 얼마나 걸러낼지 추정하지 못했고, 그래서 두 입력을 그대로 곱한 것으로 보인다.
조인이 끝나기까지 걸린 시간은 1,270ms다. 이 값에는 하위 단계인 p 테이블 스캔과 필터링(310ms), l 테이블 스캔(393ms)이 포함돼 있다. 둘을 빼면 조인 매칭에만 약 567ms가 걸렸다. 그 결과 205만 행(2.05e+6)이 다음 단계로 넘어갔다.
해시 조인이 선택된 이유는 l 테이블에서 product_id로 행을 찾아갈 인덱스가 없기 때문이다. 그래서 l.product_id를 인덱스 후보로 올린다.
-> Table scan on <temporary>  (actual time=3571..3667 rows=820942 loops=1)
     -> Aggregate using temporary table  (actual time=3571..3571 rows=820941 loops=1)
Aggregate using temporary table
그 이유는 바로 앞 단계인 Left hash join에 있다. 해시 조인은 한쪽 테이블로 해시 테이블을 만들고, 다른 쪽 테이블의 행을 하나씩 대조해 매칭하는 방식이다. 해시 테이블이 메모리에 다 들어가면 결과는 대체로 대조하는 쪽 순서대로 나온다. 하지만 메모리가 부족하면 양쪽 행을 해시값 기준으로 여러 조각으로 나눠 디스크에 쓰고, 조각 단위로 조인한다. 이렇게 되면 결과가 1, 1, 1, 2, 2, 2처럼 모여서 나오지 않고 1, 2, 3, 1, 2, 3처럼 섞여서 나올 수 있다.
옵티마이저는 실행 전에 메모리가 넘칠지 알 수 없다. 그래서 해시 조인의 결과는 p.id 순서가 보장되지 않는 것으로 취급한다. 순서가 보장되지 않은 상태에서 GROUP BY p.id를 수행하려면, 흩어져 들어오는 p.id 행들을 모아 둘 작업 공간이 필요하다. 같은 p.id가 나중에 또 나올 수 있으니 모든 그룹의 집계값을 끝까지 들고 있어야 하기 때문이다. 먼저 p.id로 정렬한 뒤 차례대로 세는 방법도 있지만, 옵티마이저는 임시 테이블을 택했다. 그래서 Aggregate using temporary table 단계가 나타난다.
이 단계에서 특이한 점은 다른 단계와 달리 비용(Cost) 정보가 따로 표시되지 않는다는 것이다. 실제 실행 시간은 3,571..3,571ms로 찍혔다. actual time은 그 단계가 시작된 뒤부터 잰 시간이며, 하위 단계의 시간을 포함한다. 앞의 숫자는 첫 행이 나온 시점, 뒤의 숫자는 마지막 행이 나온 시점이다. 두 숫자가 같은 이유는 임시 테이블을 다 채우기 전까지는 한 행도 내보낼 수 없기 때문이다. 이 단계가 혼자 쓴 시간은 바로 아래 조인의 1,270ms를 빼서 구하며, 약 2,300ms다. 이 시간 동안 조인 결과 205만 행을 읽어 820,941개 그룹으로 묶었다. 쿼리 전체 시간 3,717ms 가운데 가장 큰 덩어리다.
집계가 끝나면 Table scan on <temporary> 단계에서 방금 만든 임시 테이블을 다시 읽어 결과를 꺼낸다. 원래 테이블을 풀 스캔하는 것과는 성격이 다르며, 임시 테이블로 집계하면 항상 따라오는 과정이다. actual time은 3,571..3,667ms로, 첫 행이 3,571ms에, 마지막 행이 3,667ms에 나왔다. 이 단계가 혼자 쓴 시간은 약 96ms이고, 820,942행을 읽어 위로 넘겼다.
여기서는 p.id로 GROUP BY를 하고 있다. 하지만 p.id는 PK라서 이미 인덱스가 걸려 있으므로, 새로 인덱스를 걸 후보에서는 제외한다.
Sort: `count(l.id)` DESC, p.id DESC, limit input to 20 row(s) per chunk (actual time=3717..3717 rows=20 loops=1)Sort
이름 그대로 정렬하는 단계다. count(l.id) 내림차순, 같으면 p.id 내림차순으로 정렬한다. 눈여겨볼 부분은 limit input to 20 row(s) per chunk다. 82만 개 그룹을 전부 정렬하지 않고, 읽어 들이면서 상위 20개만 남기고 나머지는 버린다는 뜻이다. 바로 위의 LIMIT 20을 정렬 단계가 미리 반영한 것이다.
이 단계도 예측 비용은 표시되지 않는다. 실제 시간은 3,717..3,717ms로, 첫 행과 마지막 행이 같은 시점에 나왔다. 정렬은 입력을 끝까지 다 읽어야 무엇이 1등인지 알 수 있으므로, 다 읽기 전에는 한 행도 내보낼 수 없기 때문이다. 이 단계가 혼자 쓴 시간은 아래 Table scan on <temporary>의 3,667ms를 빼서 약 50ms다. 82만 행을 다 정렬하지 않고 상위 20개만 유지했기 때문에 이 정도에 그친 것으로 보인다.
-> Limit: 20 row(s) (actual time=3717..3717 rows=20 loops=1)Limit
마지막 단계다. 결과에서 20개만 내보낸다. 특이한 점은 바로 아래 Sort가 이미 상위 20개만 남겼는데도 Limit이 따로 한 번 더 나온다는 것이다.
이유는 Sort에 찍힌 per chunk에 있다. 정렬할 데이터가 메모리에 다 들어가지 않으면 MySQL은 여러 조각(chunk)으로 나눠 정렬한다. 이때 조각마다 상위 20개씩 남기므로, 합치면 20개를 넘을 수 있다. 그래서 최종적으로 20개를 자르는 일은 Limit이 맡는다. Sort의 20개 제한은 정렬 작업을 줄이기 위한 최적화이고, LIMIT 20을 실제로 보장하는 건 이 단계다.
실제 시간은 3,717..3,717ms로 Sort와 같다. 이미 정렬된 20행을 그대로 넘기기만 하므로, 이 단계가 혼자 쓴 시간은 사실상 0이다. 그리고 이 3,717ms가 쿼리 전체 실행 시간이다.
이제 이걸 가지고 뭘 하지?
먼저 인덱스 후보군은 현재 총 3개였다. l.product_id, status, deleted_at다. 먼저 l 테이블의 product_id에 인덱스를 걸고 실행해보겠습니다.
-> Limit: 20 row(s)  (actual time=1686..1686 rows=20 loops=1)
    -> Sort: `count(l.id)` DESC, p.id DESC, limit input to 20 row(s) per chunk  (actual time=1686..1686 rows=20 loops=1)
        -> Stream results  (cost=195438 rows=232174) (actual time=1.12..1633 rows=820942 loops=1)
            -> Group aggregate: count(l.id)  (cost=195438 rows=232174) (actual time=1.12..1574 rows=820942 loops=1)
                -> Nested loop left join  (cost=172220 rows=232174) (actual time=1.08..1439 rows=2.05e+6 loops=1)
                    -> Filter: ((p.`status` = 'SELLING') and (p.deleted_at is null))  (cost=100406 rows=48238) (actual time=0.758..380 rows=820942 loops=1)
                        -> Index scan on p using PRIMARY  (cost=100406 rows=964759) (actual time=0.737..288 rows=1e+6 loops=1)
                    -> Covering index lookup on l using idx_like_product (product_id=p.id)  (cost=1.01 rows=4.81) (actual time=895e-6..0.00112 rows=1.89 loops=820942)
앞에서처럼 모든 단계를 하나하나 볼 수는 없으니, 이번에는 눈에 띄는 부분만 짚어 보겠다. 먼저 인덱스가 실제로 쓰인 것을 확인할 수 있었다. 전체 실행 시간은 약 1.6초였다.
그 다음에 확인해볼 칼럼은 status, deleted_at다. 이 둘 중 인덱스를 걸기전 생각해야되는 부분이 있다. where절의 순서를 바꾸면 시간이 바뀔까? 현재는 다음과 같이 where절이 설정되어있다.
WHERE p.deleted_at IS NULL AND p.status='SELLING'이 두개의 칼럼의 위치를 바꾼다면 어떻게 될까?
-> Limit: 20 row(s)  (actual time=1485..1485 rows=20 loops=1)
    -> Sort: `count(l.id)` DESC, p.id DESC, limit input to 20 row(s) per chunk  (actual time=1485..1485 rows=20 loops=1)
        -> Stream results  (cost=195438 rows=232174) (actual time=0.104..1433 rows=820942 loops=1)
            -> Group aggregate: count(l.id)  (cost=195438 rows=232174) (actual time=0.102..1376 rows=820942 loops=1)
                -> Nested loop left join  (cost=172220 rows=232174) (actual time=0.0964..1243 rows=2.05e+6 loops=1)
                    -> Filter: ((p.`status` = 'SELLING') and (p.deleted_at is null))  (cost=100406 rows=48238) (actual time=0.0749..262 rows=820942 loops=1)
                        -> Index scan on p using PRIMARY  (cost=100406 rows=964759) (actual time=0.0724..173 rows=1e+6 loops=1)
                    -> Covering index lookup on l using idx_like_product (product_id=p.id)  (cost=1.01 rows=4.81) (actual time=829e-6..0.00103 rows=1.89 loops=820942)
빨라지긴하였지만 근소한 차이라 이게 유의미한지는 모르겠다. 그래서 원 상태로 돌렸다.
먼저 deleted_at부터 인덱스를 걸어보자.
-> Limit: 20 row(s)  (actual time=2226..2226 rows=20 loops=1)
    -> Sort: `count(l.id)` DESC, p.id DESC, limit input to 20 row(s) per chunk  (actual time=2226..2226 rows=20 loops=1)
        -> Stream results  (cost=513556 rows=964759) (actual time=0.437..2174 rows=820942 loops=1)
            -> Group aggregate: count(l.id)  (cost=513556 rows=964759) (actual time=0.434..2118 rows=820942 loops=1)
                -> Nested loop left join  (cost=397469 rows=1.16e+6) (actual time=0.417..1987 rows=2.05e+6 loops=1)
                    -> Filter: (p.`status` = 'SELLING')  (cost=38400 rows=241190) (actual time=0.317..962 rows=820942 loops=1)
                        -> Index lookup on p using idx_product_deleted_at (deleted_at=NULL), with index condition: (p.deleted_at is null)  (cost=38400 rows=482379) (actual time=0.313..886 rows=949523 loops=1)
                    -> Covering index lookup on l using idx_like_product (product_id=p.id)  (cost=1.01 rows=4.81) (actual time=875e-6..0.00108 rows=1.89 loops=820942)
인덱스를 걸었는데도 시간이 증가한것을 확인 할 수 있었다.
왜 느려졌나
1. 거의 모든 행이 조건에 맞았다. 100만 행 중 949,523행, 즉 95%가 deleted_at IS NULL이었다. 인덱스로 걸러낼 게 거의 없었다.
2. 인덱스를 거치면 행마다 한 번 더 찾아가야 한다. idx_product_deleted_at에는 deleted_at과 id만 들어 있다. 그런데 바로 다음 단계에서 status를 확인해야 하니, 95만 행 각각에 대해 id로 PK 인덱스를 다시 타고 내려가 행 전체를 읽었다.
3. PK로 읽으면 그 과정이 없다. 테이블 데이터를 저장 순서대로 쭉 훑기만 하면 된다. 정리하면, 95만 번 따로 찾아가는 비용이 100만 행을 한 번에 훑는 비용보다 컸다.
그럼에도 불구하고 옵티마이저는 왜 이 인덱스를 골랐나
예측이 틀렸기 때문이다. rows=482379로, NULL인 행을 절반 정도로 봤다. 실제는 95%였다. 그래서 cost를 38,400으로 계산했고, PK 스캔(101,197)보다 싸다고 판단했다.
이 결과는 앞서 Filter 구간에서 "통과 비율이 높아 인덱스 효과는 측정해서 확인해야 한다"고 쓴 내용을 숫자로 확인한 셈이다. 그리고 "인덱스를 걸면 빨라진다"는 생각에 대한 반례이기도 하다.
그럼 status은 어떨까?
status도 상황은 달라지지 않았다.
-> Limit: 20 row(s)  (actual time=2548..2548 rows=20 loops=1)
    -> Sort: `count(l.id)` DESC, p.id DESC, limit input to 20 row(s) per chunk  (actual time=2548..2548 rows=20 loops=1)
        -> Stream results  (cost=115209 rows=232174) (actual time=4.84..2496 rows=820942 loops=1)
            -> Group aggregate: count(l.id)  (cost=115209 rows=232174) (actual time=4.83..2438 rows=820942 loops=1)
                -> Nested loop left join  (cost=91991 rows=232174) (actual time=4.81..2306 rows=2.05e+6 loops=1)
                    -> Filter: (p.deleted_at is null)  (cost=20177 rows=48238) (actual time=4.73..1238 rows=820942 loops=1)
                        -> Index lookup on p using idx_product_status (status='SELLING'), with index condition: (p.`status` = 'SELLING')  (cost=20177 rows=482379) (actual time=4.73..1202 rows=864232 loops=1)
                    -> Covering index lookup on l using idx_like_product (product_id=p.id)  (cost=1.01 rows=4.81) (actual time=918e-6..0.00113 rows=1.89 loops=820942)
역시나 상황은 똑같이 오래걸렸다.
그렇다면 두 개를 동시에 걸어보자.
-> Limit: 20 row(s)  (actual time=1379..1379 rows=20 loops=1)
    -> Sort: `count(l.id)` DESC, p.id DESC, limit input to 20 row(s) per chunk  (actual time=1379..1379 rows=20 loops=1)
        -> Stream results  (cost=1.09e+6 rows=1.05e+6) (actual time=0.0514..1326 rows=820942 loops=1)
            -> Group aggregate: count(l.id)  (cost=1.09e+6 rows=1.05e+6) (actual time=0.0501..1267 rows=820942 loops=1)
                -> Nested loop left join  (cost=837026 rows=2.53e+6) (actual time=0.0434..1132 rows=2.05e+6 loops=1)
                    -> Filter: ((p.`status` = 'SELLING') and (p.deleted_at is null))  (cost=53767 rows=526121) (actual time=0.0358..193 rows=820942 loops=1)
                        -> Covering index lookup on p using idx_product_status_deleted_at (status='SELLING', deleted_at=NULL)  (cost=53767 rows=526121) (actual time=0.0338..113 rows=820942 loops=1)
                    -> Covering index lookup on l using idx_like_product (product_id=p.id)  (cost=1.01 rows=4.81) (actual time=783e-6..973e-6 rows=1.89 loops=820942)
시간은 빨라졌지만 압도적으로 좋아지지는 않았다. 오히려 없어도 된다고 느꼈다. 3초에서 1초대로 줄어든 건 좋은 일이지만, 극적으로 줄었다고 보기는 어렵다.
왜 더 줄지 않았을까. 지금 남은 1초대는 대부분 쿼리 구조에서 나온다. 82만 개 상품의 좋아요를 전부 세고, 그다음에야 상위 20개를 고르는 구조다. 인덱스는 이 작업을 빠르게 해 줄 수는 있어도 작업량 자체를 없애지는 못한다. 정렬 기준인 count(l.id)가 실행할 때마다 계산되는 값이기 때문이다. 복합 인덱스가 큰 차이를 내지 못한 것도 같은 이유다. 걸러내는 행이 거의 없으니 읽는 양이 그대로였다.
그렇다면 다시 질문으로 돌아가야 한다.
1. 1초면 충분한가? 처음에 던졌던 "얼마나 느려야 느린 건가"라는 질문이다. 인기순 목록의 응답 목표가 몇 ms인지 정해야 1초가 좋은 결과인지 부족한 결과인지 말할 수 있다.
2. 부족하다면 작업량 자체를 어떻게 줄일 것인가? 정렬 기준이 실행할 때마다 계산된다는 게 원인이니, 그 값을 미리 계산해 둘 수 있는지가 다음 질문이다. 어디에 둘지, 얼마나 늦게 갱신돼도 괜찮은지가 함께 따라온다.
인덱스로 줄일 수 있는 만큼은 줄였고, 남은 시간은 구조 때문이라는 걸 측정으로 확인했다.
'개발' 카테고리의 다른 글
| 낙관락은 시스템의 일환으로 동작하고, 비관락은 통제에 의해 동작한다. (0) | 2026.10.09 |
|---|---|
| 유스케이스만으로 설계를 완성시킬 수 있을까? (0) | 2026.09.20 |
| 설계문서를 왜 작성해야 할까? (0) | 2026.09.11 |
| 카산드라가 무중단을 지원할 수 있는 이유 (0) | 2026.08.16 |
| 안정 해시(intro.) (0) | 2026.07.28 |